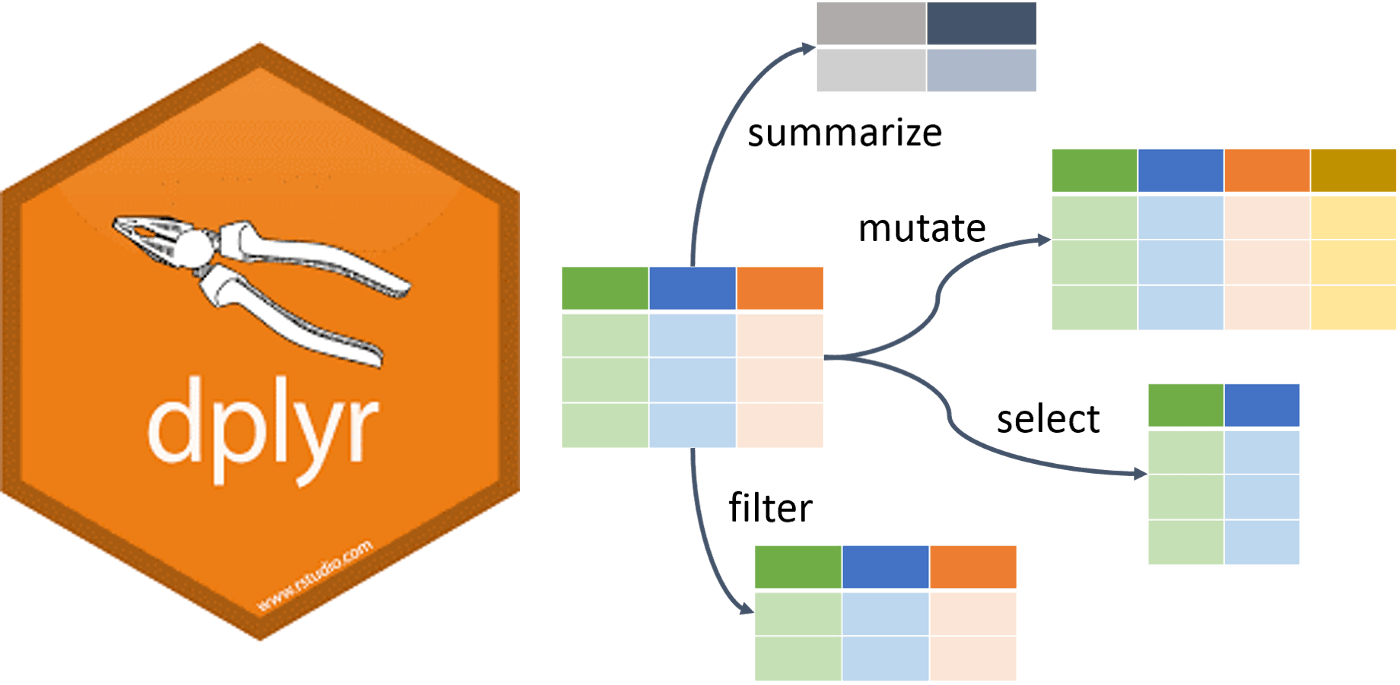
¿Quieres aprender a simplificar las 10 operaciones más frecuentes que realizas con tus datos? Te enseñaré trucos para manipular, limpiar y resumir datos con rapidez y efectividad. Conoce las mejores herramientas que el paquete dplyr de R te puede ofrecer.
En el post anterior te enseñé qué es el paquete dplyr y para qué aplicaciones puedes utilizarlo. Hoy veremos mis 10 tareas de manipulación favoritas con dplyr.
Contenidos
- 1. Resumir múltiples columnas
- 2. Seleccionar filas con los valores máximos en cada grupo
- 3. Aplicar una función a cada fila de una tabla
- 4. Frecuencias / proporciones relativas
- 5. Eliminar filas duplicadas
- 6. Cambiar el nombre de las variables
- 7. Seleccionar casos completos
- 8. Suma a través de múltiples filas/columnas
- 9. Contar el número de casos o filas
- 10. Contar el número de casos o filas únicas (con NAs)
Aplicación con datos de flores de lirios (iris)
Utilizaremos como ejemplo los datos iris que vienen precargados en R sobre el largo y ancho de sépalos y pétalos en 3 especies de flores de lirios.
> data(iris)> head(iris)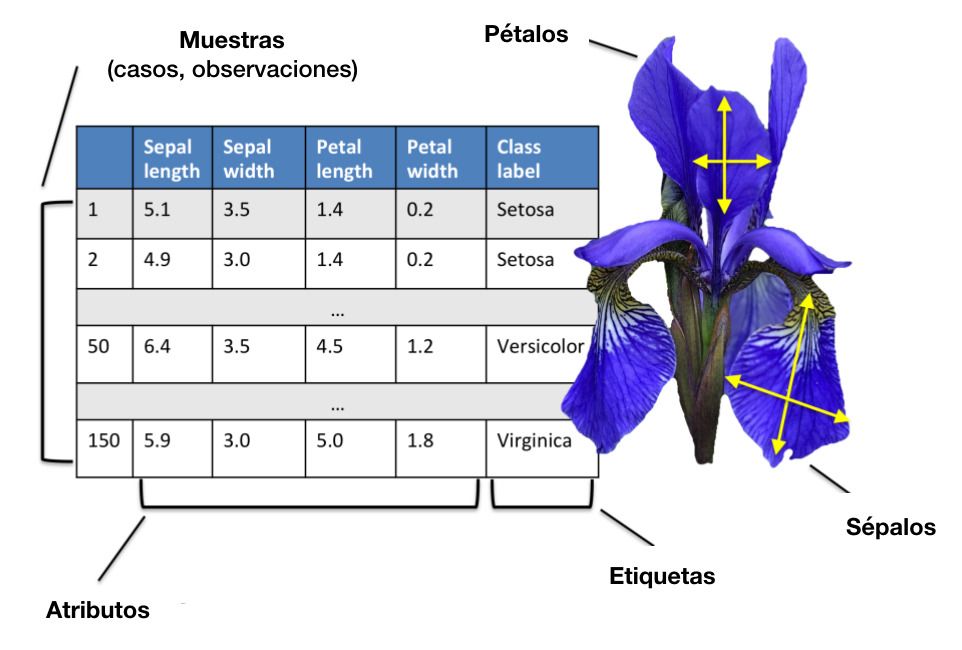
1. Resume múltiples columnas
¿Cuál es la media del largo y ancho de sépalos y pétalos para cada especie?
> iris %>%
group_by(Species) %>%
summarise_all(mean)
# A tibble: 3 x 5
  Species    Sepal.Length Sepal.Width Petal.Length Petal.Width
  <fct>             <dbl>       <dbl>        <dbl>       <dbl>
1 setosa             5.01        3.43         1.46       0.246
2 versicolor         5.94        2.77         4.26       1.33
3 virginica          6.59        2.97         5.55       2.03
Si deseas resumir solo ciertas columnas, utiliza las funciones summarise_at o summarise_if.
2. Selecciona filas con los valores máximos en cada grupo
Imagina que solo quieres obtener aquel caso con mayor valor de largo de sépalos, para cada especie.
> iris %>%
+   group_by(Species) %>%
+   filter(Sepal.Length == max(Sepal.Length)) %>%
+   arrange(Species)
# A tibble: 3 x 5
# Groups:   Species [3]
  Sepal.Length Sepal.Width Petal.Length Petal.Width Species
         <dbl>       <dbl>        <dbl>       <dbl> <fct>
1          5.8         4            1.2         0.2 setosa
2          7           3.2          4.7         1.4 versicolor
3          7.9         3.8          6.4         2   virginica
De manera equivalente, puedes utilizar:
> iris %>%
+     group_by(Species) %>%
+     slice(which.max(Sepal.Length))
# A tibble: 3 × 5
# Groups:   Species [3]

Sepal.Length Sepal.Width Petal.Length Petal.Width Species

<dbl>       <dbl>        <dbl>       <dbl> <fct>
1          5.8         4            1.2         0.2 setosa

2          7           3.2          4.7         1.4 versicolor
3          7.9         3.8          6.4         2   virginica
3. Aplica una función a cada fila de una tabla
Y si quieres calcular una nueva variable (columna) con el valor máximo del largo de sépalos o pétalos, hacemos lo siguiente:
> iris %>%
+   rowwise() %>%
+   mutate(Max.Len= max(Sepal.Length,Petal.Length))
Source: local data frame [150 x 6]
Groups: <by row>
# A tibble: 150 x 6
   Sepal.Length Sepal.Width Petal.Length Petal.Width Species Max.Len
          <dbl>       <dbl>        <dbl>       <dbl> <fct>     <dbl>
 1          5.1         3.5          1.4         0.2 setosa      5.1
 2          4.9         3            1.4         0.2 setosa      4.9
 3          4.7         3.2          1.3         0.2 setosa      4.7
 4          4.6         3.1          1.5         0.2 setosa      4.6
# … with 140 more rows
4. Obtén las frecuencias relativas o proporciones
¿Qué % de casos tenemos por especie?
> iris %>%
+ group_by(Species) %>%
+ summarise(n = n()) %>%
+ mutate(freq = n / sum(n))
# A tibble: 3 × 3
Species n freq
1 setosa 50 0.333
2 versicolor 50 0.333
3 virginica 50 0.333
En este caso tenemos 50 flores (casos o filas) para cada especie, por lo tanto hay un 33% de la muestra que corresponde a la especie de lirio setosa, 33% a veriscolor y 33% a virginica.
5. Elimina filas duplicadas
Esta es una tarea habitual en la manipulación de datos, pero es fácil de solucionar con la función distinct():
> iris %>%
distinct(Species)
    Species
1  setosa
2  versicolor
3  virginica
Nos muestra que la variable "Species" solo tiene 3 etiquetas distintas: setosa, virginica y vericolor
6. Cambia el nombre de las variables
A menudo necesitamos acortar los nombres de las variables (columnas), para escribir código de manera más sencilla y rápida. Por ejemplo, aquí llamaremos "SL" a la variable "Sepal.Length" para evitar errores de escritura con las mayúsculas, puntos y el inglés. Para renombrar las columnas podemos escribir lo siguiente:
> iris %>%
rename(SL = Sepal.Length) %>%
head()
   SL Sepal.Width Petal.Length Petal.Width Species
1 5.1         3.5          1.4         0.2  setosa
2 4.9         3.0          1.4         0.2  setosa
3 4.7         3.2          1.3         0.2  setosa
4 4.6         3.1          1.5         0.2  setosa
5 5.0         3.6          1.4         0.2  setosa
6 5.4         3.9          1.7         0.4  setosa
Vemos que solo ha cambiado el nombre de la columna seleccionada.
7. Selecciona casos completos
¿Cómo quedarnos con las observaciones completas? Construimos un conjunto de datos ficticio que contenga valores perdidos (o faltantes, NA) para el ejemplo:
> df <- tibble(x = c(1, 2, NA), y = c("a", NA, "b"))
> df
# A tibble: 3 x 2
      x y
  <dbl> <chr>
1     1 a
2     2 NA
3    NA b
Si queremos descartar todos los casos que contengan NA, escribimos:
> df %>% drop_na()
# A tibble: 1 x 2
      x y
  <dbl> <chr>
1     1 a
Si queremos descartar casos en función de una variable:
> df %>% drop_na(x)
# A tibble: 2 x 2
      x y
  <dbl> <chr>
1     1 a
2     2 NA
También puedes utilizar las funciones na.omit(), filter(complete.cases(.)) o filter(!is.na(x1)).
8. Suma a través de múltiples filas/columnas
Creamos un conjunto de datos de ejemplo, imagina que 1 es presencia y 0 ausencia (o Sí/NO).
> df=data.frame(
   x1=c(1,0,0,NA,0,1,1,NA,0,1),
   x2=c(1,1,NA,1,1,0,NA,NA,0,1),
   x3=c(0,1,0,1,1,0,NA,NA,0,1))
> df
   x1 x2 x3
1   1  1  0
2   0  1  1
3   0 NA  0
4  NA  1  1
5   0  1  1
6   1  0  0
7   1 NA NA
8  NA NA NA
9   0  0  0
10  1  1  1
Para realizar la suma, imagina que podemos reemplazar los NA por cero (ausencia de información y ausencia del evento). Para resumir todas las columnas usamos summarise_all:
> df %>%
    replace(is.na(.), 0) %>%
    summarise_all(funs(sum))
 x1 x2 x3
1  4  5  4
Para resumir cada fila:
> df %>%
    replace(is.na(.), 0) %>%
    mutate(sum = rowSums(.[1:3]))
  x1 x2 x3 sum
1   1  1  0   2
2   0  1  1   2
3   0  0  0   0
4   0  1  1   2
5   0  1  1   2
6   1  0  0   1
7   1  0  0   1
8   0  0  0   0
9   0  0  0   0
10  1  1  1   3
9. Cuenta el número de casos o filas
Esto es muy importante, porque cuando resumimos los datos en estadísticos descriptivos deberíamos tener en cuenta el número de observaciones que se ha utilizado para ello:
> iris %>%
group_by(Species) %>%
summarise(n = n(), meanSL = mean(Sepal.Length))
# A tibble: 3 × 3

Species        n meanSL

<fct>      <int>  <dbl>
1 setosa        50   5.01

2 versicolor    50   5.94

3 virginica     50   6.59
También puedes utilizar la función count:
> iris %>%
group_by(Species) %>%
count()
A tibble: 3 × 2
Groups: Species [3]
Species n
1 setosa 50
2 versicolor 50
3 virginica 50
10. Cuenta el número de casos o filas únicas (con NAs)
Cuando tenemos un conjunto de datos con NAs podemos contar el número de casos o filas únicas con la función n_distinct().
Creamos un conjunto de datos ficticio para el ejemplo.
> data=data.frame(aa=c(1,2,3,4,NA), bb=c('a', 'b', 'a', 'c', 'c'))
> data
 aa bb
1  1  a
2  2  b
3  3  a
4  4  c
5 NA  c

> data %>%
+   filter(!is.na(aa)) %>%
+   group_by(bb) %>%
+   summarise(Unique_Elements = n_distinct(aa))
# A tibble: 3 x 2
  bb    Unique_Elements
  <fct>           <int>
1 a                   2
2 b                   1
3 c                   1
Por ejemplo, aquí hemos seleccionado los casos que no tienen NA en la variable "aa" y contado los casos distintos para la variable "bb".
Si quieres aprender mucho más sobre R y dplyr, ¡apúntate al curso de Introducción a Data Science y domina R y R Studio!